中国 AI 算力和电力的中国版图
“当美国用 5 万亿美元 Stargate + 1 GW 阿布扎比时,中国用什么对标?答案是:东数西算 + 国产芯片 + 特高压电网。这是 AI 时代的’两弹一星’。“
一、中美 AI 算力首次完全对等
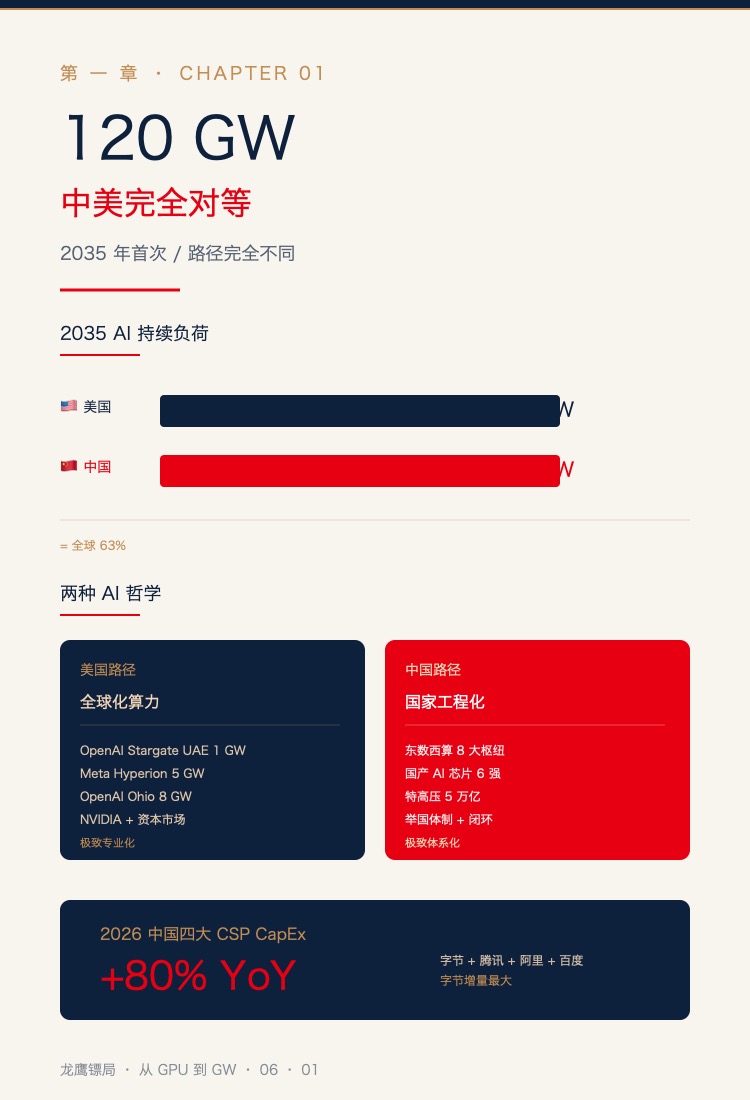
2035 年是一个历史性的年份——中国 AI 持续负荷将达到 120 GW,与美国 120 GW 完全对等。
这不只是个数字。回看 2020 年,中国 AI 算力几乎是美国的零头。NVIDIA 的 GPU 在中国一度一卡难求,美国出口管制层层加码。
但到 2035 年,两国将达到同一个数量级。
(ps: 这是 AI 算力格局的”斯普特尼克时刻”——美国不再是无可争议的领先者,中美进入”双雄”格局。)
但实现路径完全不同。
- 美国路径:OpenAI Stargate 1 GW 建在阿布扎比 + 美国本土三大数据中心集群(Meta Hyperion 5 GW、OpenAI Ohio 8 GW、Microsoft 三里岛 837 MW)= 全球化路径
- 中国路径:东数西算 8 大枢纽 + 国产 AI 芯片闭环 + 特高压电网 = 国家工程化路径
这是两种完全不同的 AI 哲学——
美国押注全球最聪明的人 + 全球最便宜的能源,中国押注举国体制 + 完整闭环。
可能有人会说:中国 AI 算力还是依赖 NVIDIA,美国的 H200/B200 性能远超国产芯片。
这是个事实。但这只是”芯片层”的对比。如果我们把视野扩展到 5 个层级(芯片 + 数据中心 + 电力 + 资本 + 政策),中国在 4 个层级都有结构性优势。
哪个会赢?现在下结论还太早。
二、中国 AI 算力 4 大家族
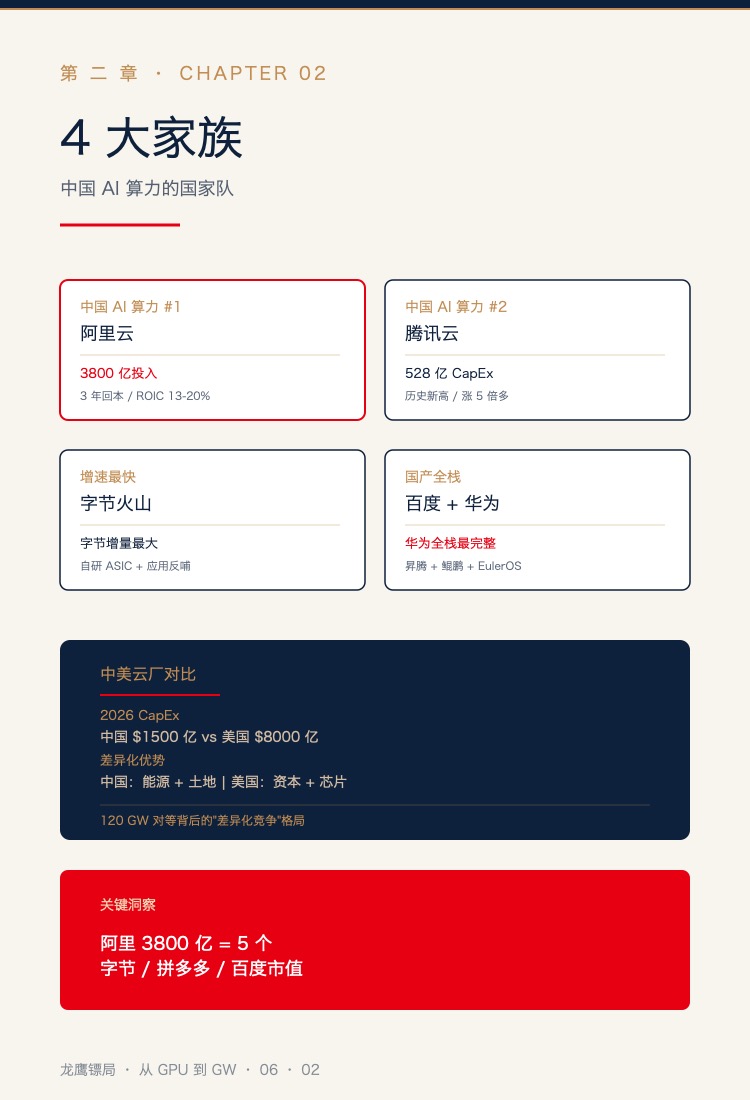
中国 AI 算力的”国家队”,由四大云 + 华为云组成。
2.1 阿里云:3800 亿投入 + 三年回本
2026 年 8 月,阿里巴巴公布了一项惊人的计划——未来 3 年投入 3800 亿元(约 530 亿美元)用于 AI 算力基础设施。
(ps: 这个数字相当于 Meta 2026 全年 CapEx 的一半。阿里一家公司的 AI 投入,就超过了绝大多数中国一线互联网公司的市值。)
摩根士丹利的测算显示:中国头部云厂 ROIC(投资回报率)可达 13-20%——其中阿里云最具优势。
阿里云已经率先在乌兰察布、宁夏中卫、和林格尔等东数西算枢纽落地”超节点”实例——这是中国 AI 算力从”概念”走向”规模商用”的标志性事件。
2.2 腾讯:528 亿”烧钱”
2026 年,腾讯资本开支 528 亿元——历史新高。
(ps: 腾讯 2024 年 CapEx 还不到 100 亿。2026 年涨了 5 倍多。这意味着腾讯的”轻资产”时代正式结束,进入”重资产 AI 时代”。)
腾讯的重点投入:自研混元大模型 + GPU 集群 + 算力基础设施。
2.3 字节火山引擎:增速最快
字节跳动旗下的火山引擎,是国内 AI 算力增速最快的云厂。
TrendForce 预测:字节是中国四大 CSP 中 2026 年 CapEx 增量最大的。自研 ASIC + 大规模 GPU 集群是核心策略。
(ps: 字节跳动的优势是”应用反哺算力”——抖音 / TikTok / 即梦的 AI 应用已经验证 ROI,可以直接驱动算力扩张。)
2.4 百度智能云 + 华为云
- 百度智能云:文心一言 + 自研昆仑芯片 + 千帆大模型平台
- 华为云:昇腾 + 盘古大模型,国内最大的国产 AI 全栈方案
华为云的特殊性:它不只卖算力,而是卖”昇腾 + 鲲鹏 + EulerOS + 昇思 MindSpore”的完整国产 AI 栈。这是中国唯一能与美国”全栈”对标的公司。
2.5 中国云厂与美国的对比
| 维度 | 中国四大云 | 美国五大 Hyperscaler |
|---|---|---|
| CapEx(2026) | ~1500 亿美元(含字节) | ~8000 亿美元 |
| 投资节奏 | 短-中-长期 | 短-中-长期 |
| 能源保障 | 特高压 + 算电协同(优势) | 变压器 4 年交付(劣势) |
| 芯片 | 国产替代(劣势但加速) | NVIDIA 70% 垄断(优势) |
| 土地 | 国家工程化(优势) | 加州/俄亥俄审批困难(劣势) |
(ps: 表格清晰显示——中国云在能源和土地上占优,美国云在资本和芯片上占优。这是 120 GW 对等背后的”差异化竞争”格局。)
三、中国 AI 芯片 6 强格局
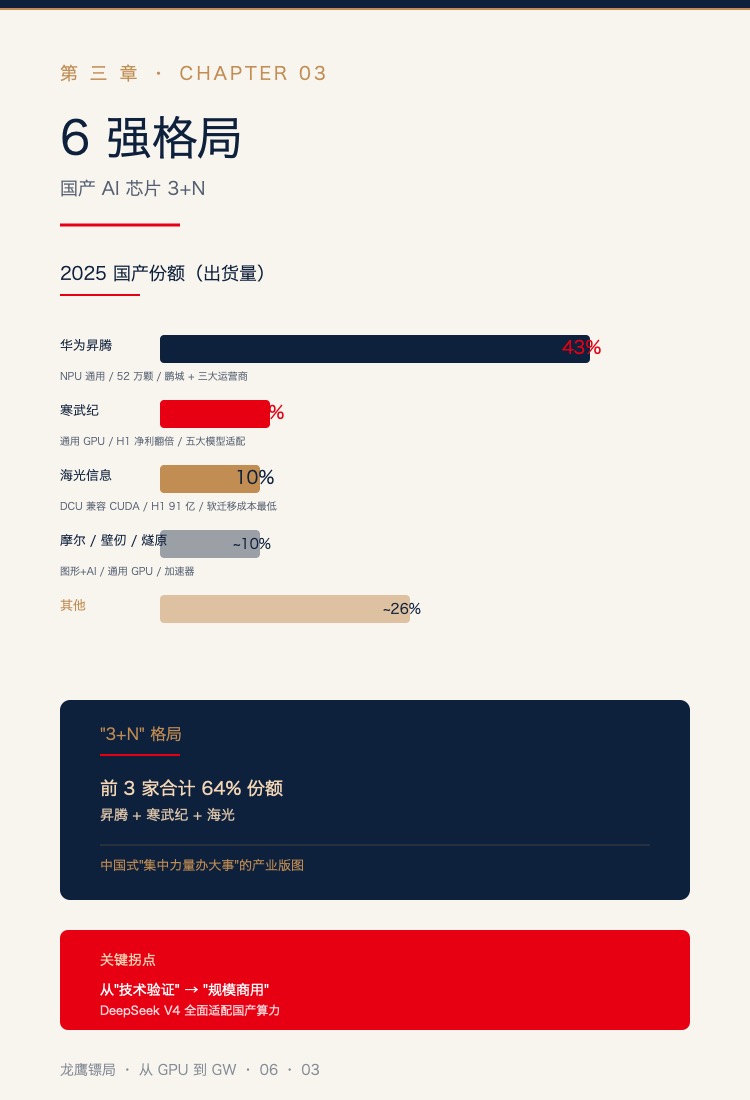
国产 AI 芯片已经从”技术验证”走向”规模商用”——这是 2025-2026 年中国 AI 产业最大的结构性变化。
3.1 6 强横向对比
| 厂商 | 2025 国产份额 | 路线 | 关键里程碑 |
|---|---|---|---|
| 华为昇腾 | 43% | NPU 通用 | 出货 52 万颗,910C 接近 H20 |
| 寒武纪 | 11% | 通用 GPU | H1 净利翻倍,五大模型适配 |
| 海光信息 | ~10% | DCU 兼容 CUDA | H1 91 亿,软迁移成本最低 |
| 摩尔线程 | ~5% | 图形+AI | MTT S5000 上市 |
| 壁仞 | ~3% | 通用 GPU | 港股 IPO 中 |
| 燧原 | ~3% | AI 加速器 | 互联网客户 |
(ps: 国产 AI 芯片的前 3 家(昇腾 + 寒武纪 + 海光)合计占 ~64%,呈现”3+N”格局——这是中国式”集中力量办大事”的产业版图。)
3.2 华为昇腾:国产份额 43%
华为昇腾是国产 AI 芯片的绝对龙头——2025 年出货 52 万颗(含自用),占国产 AI 芯片份额 43%。
Ascend 910C 性能接近 NVIDIA H20(被限制版)。客户矩阵:
- 华为云(自用)
- 鹏城实验室(中国国家算力网)
- 三大运营商(中国移动 + 电信 + 联通)
- 行业大客户:一汽、中国石油、招商局等
关键拐点:昇腾已从”国产替代”走向”规模商用”。
3.3 寒武纪:通用 GPU + 五大模型适配
2026 年 8 月,寒武纪发布 H1 业绩:净利润同比翻倍。
寒武纪走的是通用 GPU 路线(思元 590 / 690 系列),主打互联网客户。五大国产大模型(DeepSeek、文心一言、通义千问、智谱、Kimi)已完成适配。
(ps: 五大模型适配意味着——寒武纪不再是”实验室技术”,而是”商用产品”。这跟过去 5 年完全不同。)
3.4 海光信息:DCU 兼容 CUDA
2026 H1 营收 91 亿元(同比高速增长),123 亿元”备货”致现金流转负——这是产能扩张的强烈信号。
海光的独特之处:DCU 兼容 CUDA 生态——这意味着原本跑在 NVIDIA CUDA 上的算法,可以几乎零成本迁移到海光 DCU 上。
(ps: 这是中国 AI 芯片”软迁移”成本最低的方案——大量原本为 NVIDIA 写的代码可以直接跑。这也是为什么海光 2025 才开始爆发。)
3.5 摩尔 / 壁仞 / 燧原
- 摩尔线程(MTT S5000):从图形渲染扩展到 AI 通用 GPU,已上市
- 壁仞科技(BR104):通用 GPU 路线,港股 IPO 中
- 燧原科技:AI 专用加速器,主打互联网客户
四、中国 AI 电力:特高压 + 5 万亿投资
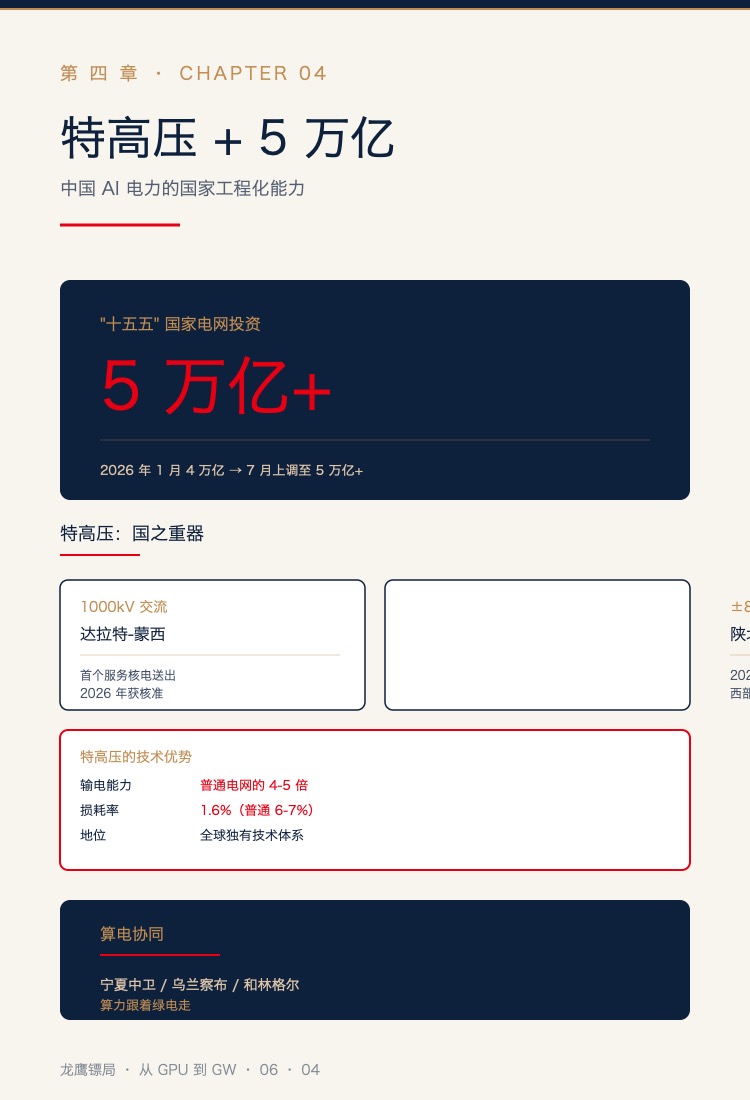
中国 AI 电力体系的”国家工程化”能力,是美国学不来的——美国没有统一规划的电网。
4.1 国家电网 4-5 万亿投资
2026 年 1 月,国家能源局公布:“十五五”期间国家电网投资规模将达 4 万亿+ 元。
到 2026 年 7 月,这一数字进一步上升——超 5 万亿。
(ps: 5 万亿是什么概念?2026 年中国 GDP 预计约 134 万亿。5 万亿 = GDP 的 3.7%。这个投入比例,在全球主要国家中是独一无二的。)
资金重点:特高压 + 新型电力系统 + 算电协同。
4.2 特高压:解决”能源区域错配”
特高压是中国 AI 电力的”国家铁路网”——把西部电力输送到东部算力中心。
两个代表性工程:
- 达拉特—蒙西 1000kV 特高压交流:首个服务核电送出的特高压工程,2026 年获核准
- 陕北—安徽 ±800kV 特高压直流:2026 年 6 月建成投运
中国”特高压”是真正的”国之重器”——1000kV 交流 + 800kV 直流,是全球独有的技术体系。
(ps: 中国特高压输电能力是普通电网的 4-5 倍,损耗只有 1.6%(普通电网 6-7%)。这是中国能搞”东数西算”的根本原因——美国没有这种技术,所以美国 AI 数据中心只能建在加州/得州,不能像中国那样建在内蒙古/贵州。)
4.3 算电协同:西部能源 + AI 算力
算电协同的核心逻辑:算力跟着绿电走——把 AI 数据中心建在能源最便宜的地方。
三大典型:
- 宁夏中卫:全国首个大规模”算电协同”绿电直供项目并网
- 内蒙古乌兰察布:阿里云超节点 + 华为 + 快手 + 世纪互联 + 远景 数据中心集群
- 内蒙古和林格尔:中国移动 + 亚信数据港
(ps: 算电协同是中国独有的”AI 时代工程化能力”——美国没有统一规划的电网,没法搞”算力跟着电走”。)
五、东数西算:8 大枢纽
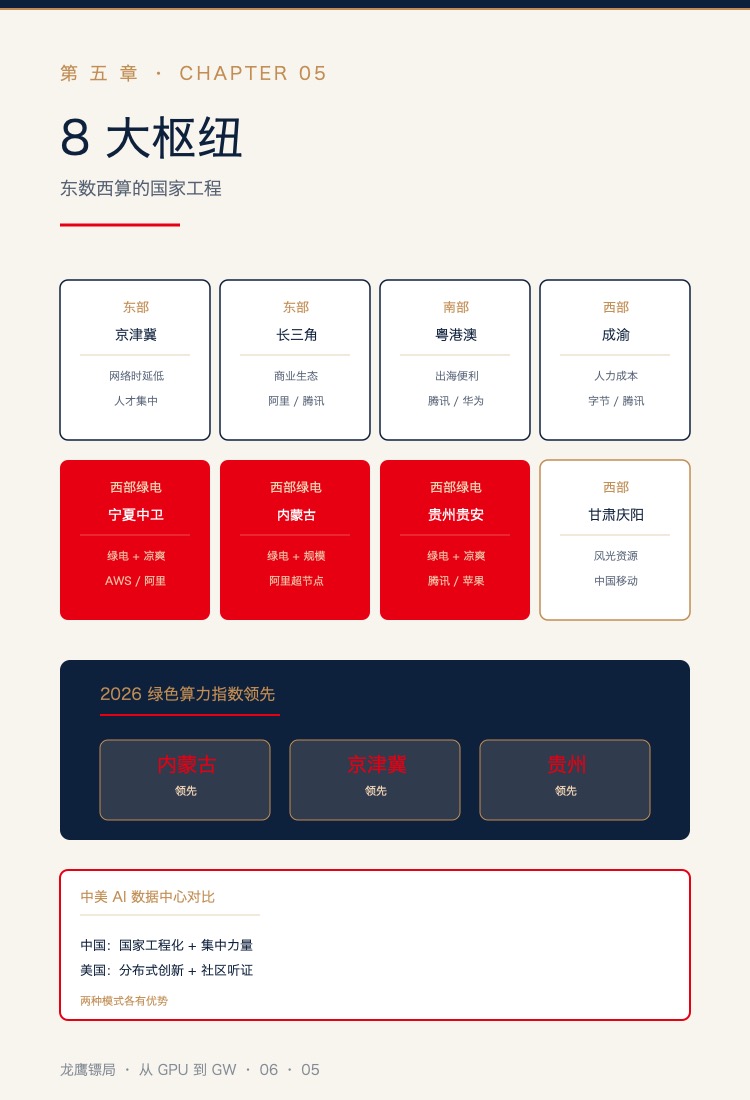
东数西算不是简单的”东数西算”——它是”重构中国 AI 算力版图”的国家工程。
5.1 八大枢纽
| 枢纽 | 位置 | 优势 | 核心玩家 |
|---|---|---|---|
| 京津冀 | 北京 + 天津 + 河北 | 网络时延低 | 阿里 / 字节 / 百度 |
| 长三角 | 上海 + 苏州 + 杭州 + 合肥 | 商业生态 | 阿里 / 腾讯 |
| 粤港澳 | 深圳 + 广州 + 东莞 | 出海 | 腾讯 / 华为 |
| 成渝 | 成都 + 重庆 | 人力成本 | 字节 / 腾讯 |
| 宁夏中卫 | 西北 | 绿电 + 凉爽 | 亚马逊 AWS / 阿里 |
| 内蒙古(乌兰察布 / 和林格尔) | 北方 | 绿电 + 规模 | 阿里云超节点 / 华为 / 快手 |
| 贵州贵安 | 西南 | 绿电 + 凉爽 | 腾讯 / 苹果 |
| 甘肃庆阳 | 西部 | 风光资源 | 中国移动 |
5.2 绿色算力指数
2026 年绿色算力报告:内蒙古、京津冀、贵州 全国一体化算力网络国家枢纽节点绿色算力发展处于领先水平。
这三个区域的共同特点:
- 可再生能源丰富(光伏 + 风电)
- 气候凉爽(自然冷却降低 PUE)
- 远离一线但网络已通达
(ps: “绿色算力指数”是 2026 年新提出的概念——它衡量的是 AI 数据中心的”绿电使用率”和”能耗效率”。中国凭借特高压 + 西部能源,在这个指标上领先全球。)
5.3 八大枢纽 vs 美国本土数据中心
| 维度 | 中国 8 大枢纽 | 美国本土 |
|---|---|---|
| 土地 | 国家工程化、统一规划 | 私人谈判、社区听证 |
| 电力 | 西部富集 + 特高压输送 | 分散、变压器 4 年 |
| 网络 | 国家骨干网 | 私营 ISP |
| 政府支持 | 中央+地方+电网联动 | 联邦-州-地方三层博弈 |
(ps: 这种结构性差异决定——中国能搞”集中力量办大事”,美国只能”分布式创新”。AI 时代两种模式各有优势。)
六、回到中美 AI 120 GW 对等
写到这里,让我们回到开头的意象——中美 AI 算力 120 GW 完全对等。
这件事的真正含义,不是”中国追上了美国”,而是:
中国走出了一条与美国完全不同的 AI 路径。
- 美国押注:OpenAI + NVIDIA + 全球化算力(OpenAI Stargate UAE 1 GW)+ 资本市场
- 中国押注:4 大家族 + 6 强芯片 + 8 大枢纽 + 5 万亿电网 = 国家工程化闭环
这是两种 AI 哲学:
- 美国路径:全球最聪明的人 + 全球最便宜的能源 → 极致专业化
- 中国路径:举国体制 + 完整产业链 + 自主可控 → 极致体系化
哪个会赢?现在下结论还太早。但有一点是确定的——
中国不和美国比 GPU 数量,中国比的是 5 万亿电网 + 8 大枢纽 + 国产芯片闭环。
这是 AI 时代的”两弹一星”——把举国体制的优势,转化为 AI 算力的硬实力。
(ps: 中美 AI 算力 120 GW 对等的真正意义,不在”追上”,而在”路径分化”。中国走自己的路,赢自己的仗。)
“AI 时代的’两弹一星’不是芯片,是国家工程化能力。5 万亿电网 + 8 大算力枢纽 + 6 强国产芯片 = 中国 AI 算力的举国体制。”
(本系列完结)
参考资料
- 国家能源局 “十五五” 4 万亿投资
- 国家能源局 5 万亿+ 电网投资
- 国家电网 单体最大特高压开工
- 国务院 东数西算 实施意见
- 2026 绿色算力指数报告
- 阿里 AI 3800 亿投资 + 三年回本
- 腾讯 528 亿 CapEx
- 字节火山引擎增速最快
- 寒武纪 H1 净利润翻倍 + 五大模型适配
- 海光 H1 91 亿 + 123 亿备货
- 华为昇腾 43% 国产份额
- 摩根士丹利 中国 AI 算力账
- 投资/行业分析/全球AI高端算力供给规模与分布结构分析.md
- 投资/行业分析/2026-2035_全球AI算力_电力地图与经济学模型.md